2026年9月15日
|
Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 是我们迄今为止最先进的实时对话模型。智能和并行推理方面的重大升级使它们更直观地协作,并可通过语音执行复杂任务。
Tom Ouyang
首席工程师
Malini Jaganathan
技术团队成员,代表 Gemini Audio 团队
收听文章
[[duration]] 分钟
此内容由 Google AI 生成。生成式 AI 处于实验阶段
今天,我们推出两款新模型,在近实时推理方面带来进步,以更有效地赋能语音代理,并让与 AI 的对话感觉更直观、更智能。
- Gemini 3.8 Live:为规模和成本效率而构建,结合了对话智能与流畅对话和视觉基础。
- Gemini 3.8 Live Extended Thinking:为高复杂度任务而构建,具有更高的智能和多步推理能力。
对于开发者和企业,这些模型提供了可靠、可用于生产的语音代理的构建模块。它们还使通过 Gemini 应用、Google Workspace 和搜索与 Gemini 交谈更加流畅和协作——帮助您仅用语音处理复杂任务。
体验更流畅、更智能的对话
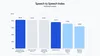
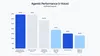
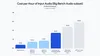
Gemini 3.8 Live Extended Thinking 提供企业级任务完成能力和智能,在 Artificial Analysis 的语音到语音质量指数中夺得总体第一名(82.6),并在代理任务完成方面领先,在 τ-Voice 上达到 68.6%,在 Sierra 的 τ-Voice-banking 基准上达到 35.1%。它还提供强大的推理能力,在 Big Bench Audio 上得分 97.7%,同时与其他前沿模型相比保持极具竞争力的价格点。
Gemini 3.8 Live 在用户中表现出高度偏好,在语音代理竞技场中排名第二。除了这一表现外,它仍然极具成本效益——为开发者和企业提供了一个为规模而构建的强大且高效的模型。

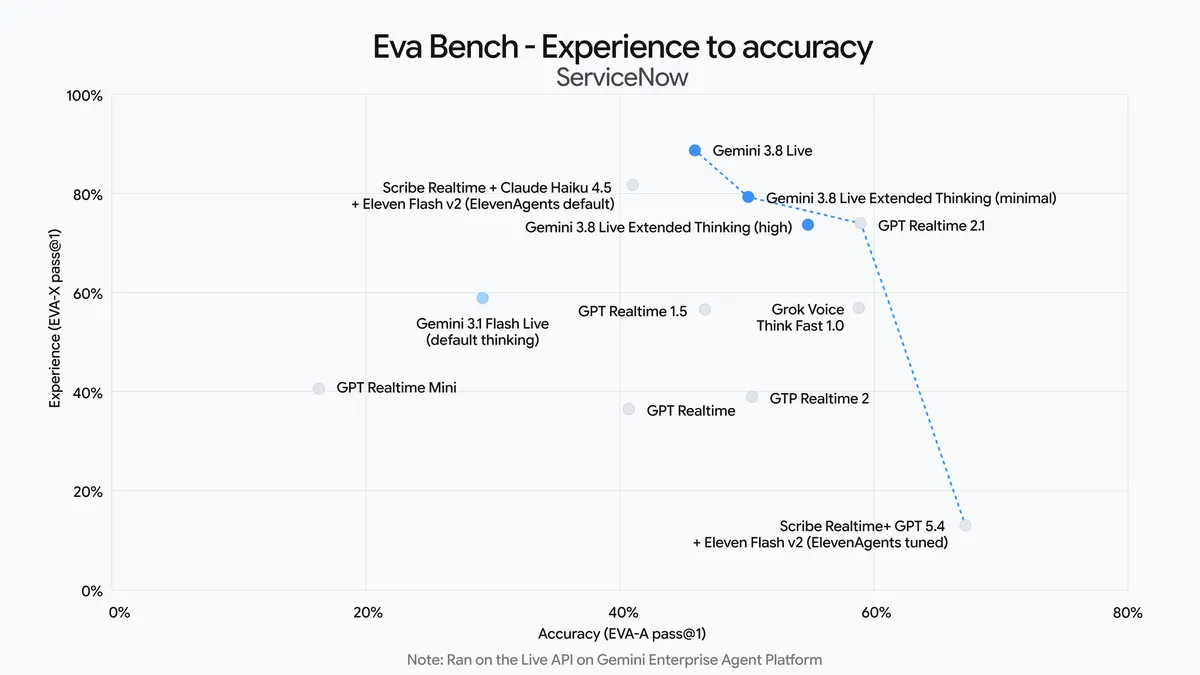
在 ServiceNow 的 EVA-Bench(一个用于评估语音代理的基准)上,我们的模型通过成功平衡准确性与对话质量,推动了复杂工作流的帕累托前沿。
注意:这是在 Gemini Enterprise Agent Platform 上的 Live API 上运行的。
Gemini 3.8 Live 近实时处理视觉输入,通过上下文丰富对话以提供更有帮助的响应。它会在对话中途自动检测并在 97 种支持的语言之间切换。它在继续对话的同时在后台执行工具和 API 调用,因此模型可以确认请求并在任务于后台完成时继续聊天。
对于需要更深层推理的任务,3.8 Live Extended Thinking 同时进行推理和说话。它为复杂工作流提供更高的智能,同时保持不间断的对话流——使用诸如“让我查一下……”之类的早期口头提示自然地确认提示,并通过实时进度叙述引导用户完成多步后台任务。
在 Google Workspace 和搜索中,我们的 Live 模型提供更直观、更协作的体验——尤其是在处理您最复杂的任务时。
在搜索 Live 中获取由 Gemini 3.8 Live 驱动的分步实时故障排除帮助。
赋能开发者和企业语音生态系统
通过使用 Gemini Live API,Agora、Fishjam、LangChain、LiveKit、Pipecat、Vercel 和 Vision Agents 等开发者平台使开发者能够轻松构建和部署高性能语音驱动界面。这些平台在幕后管理复杂的实时媒体流基础设施,让开发者能够完全专注于打造用户体验。
我们还与 Salesforce、Genspark 和 Lumeris 等公司合作,他们对 3.8 Live 和 3.8 Live Extended Thinking 感到兴奋,并强调了其令人印象深刻的延迟、流畅性和工具调用能力。
通过 SynthID 水印确保透明度
我们 AI 产品生成的所有音频均使用 SynthID 添加水印。这种不可感知的水印直接融入音频输出中,确保 AI 生成的内容可被检测,以帮助防止错误信息传播。有关我们安全与责任方法的详细信息,请查阅模型卡。
开始使用我们最新的 Gemini Audio 模型:
3.8 Live 从今天开始逐步推出:
- 面向开发者:在 Gemini API 和 Google AI Studio 中
- 面向企业:在 Gemini Enterprise 中私人预览,并即将登陆 Gemini Enterprise for Customer Experience
- 面向所有人:在 Search Live 中
3.8 Live Extended Thinking 从今天开始逐步推出:
- 面向开发者:在 Gemini API 和 Google AI Studio 中
- 面向企业:在 Gemini Enterprise 中私人预览,并即将登陆 Gemini Enterprise for Customer Experience 和 Google Workspace 商业客户
- 面向所有人:在 Gemini Live 中,以及面向 Workspace 中 Docs 的 Google AI Pro 和 Ultra 订阅者,以及 Gmail 和 Keep 中的所有 Google AI 订阅者
在您的收件箱中获取 Google 的最新消息
订阅我们的新闻通讯,获取产品更新、活动信息、特别优惠等。
您的信息将根据 Google 隐私政策 使用。您可以随时选择退出。
Sep 15, 2026
|
Gemini 3.8 Live and Gemini 3.8 Live Extended Thinking are our most advanced live dialogue models yet. Major upgrades in intelligence and parallel reasoning make them more intuitive to collaborate with and use to execute complex tasks using your voice.
Tom Ouyang
Principal Engineer
Malini Jaganathan
Member of Technical Staff, on behalf of the Gemini Audio Team
Listen to article
[[duration]] minutes
This content is generated by Google AI. Generative AI is experimental
Today, we’re introducing two new models that bring advancements in near real-time reasoning to more effectively enable voice agents and make conversing with AI feel more intuitive and intelligent.
- Gemini 3.8 Live: Built for scale and cost efficiency, combining conversational intelligence with fluid dialogue and visual grounding.
- Gemini 3.8 Live Extended Thinking: Built for high-complexity tasks, with increased intelligence and multi-step reasoning.
For developers and enterprises, these models deliver the building blocks for reliable, production-ready voice agents. They also make speaking with Gemini across the Gemini app, Google Workspace, and Search more fluid and collaborative — helping you tackle complex tasks using just your voice.
Experience more fluid, intelligent conversations
Gemini 3.8 Live Extended Thinking provides enterprise-grade task completion and intelligence, capturing the #1 overall spot on Artificial Analysis' Speech to Speech Quality Index (82.6), and leads in agentic task completion with 68.6% on τ-Voice and 35.1% on Sierra’s τ-Voice-banking benchmark. It also provides strong reasoning capabilities, scoring 97.7% on Big Bench Audio, while maintaining a highly competitive price point compared to other frontier models.
Gemini 3.8 Live has shown a high preference among users, securing a second place in the Speech Agent Arena. In addition to this performance, it remains highly cost-effective — providing developers and enterprises with a capable and efficient model built for scale.
On ServiceNow’s EVA-Bench, a benchmark for evaluating voice agents, our models push the Pareto Frontier for complex workflows by successfully balancing accuracy with conversational quality.
Note: This was run on the Live API on Gemini Enterprise Agent Platform.
Gemini 3.8 Live processes visual inputs in near real-time, enriching conversations with context for more helpful responses. It automatically detects and transitions between 97 supported languages mid-conversation. It executes tools and API calls in the background while continuing the conversation, so the model can acknowledge requests and keep chatting while tasks finish in the background.
For tasks that require deeper reasoning, 3.8 Live Extended Thinking reasons and speaks simultaneously. It delivers increased intelligence for complex workflows while maintaining an uninterrupted conversational flow — using early verbal cues like “Let me check that…” to acknowledge prompts naturally, and live progress narration to walk users through multi-step background tasks as they progress.
Across Google Workspace and Search, our Live models deliver more intuitive, collaborative experiences — especially when tackling your most complex tasks.
Get step-by-step, real-time troubleshooting help powered by Gemini 3.8 Live — right inside Search Live.
Empowering the developer and enterprise voice ecosystem
By using the Gemini Live API, developer platforms such asAgora,Fishjam, LangChain,LiveKit,Pipecat,Vercel, andVision Agents enable developers to build and deploy high-performance voice-driven interfaces with ease. These platforms manage complex real-time media streaming infrastructure behind the scenes, allowing developers to focus entirely on crafting the user experience.
We’re also partnering with companies like Salesforce, Genspark, and Lumeris who are excited about 3.8 Live and 3.8 Live Extended Thinking, highlighting its impressive latency, fluidity, and tool-calling capabilities.
Ensure transparency with SynthID watermarking
All audio generated by our AI products is watermarked with SynthID. This imperceptible watermark is woven directly into the audio output, ensuring AI-generated content remains detectable to help prevent misinformation. For details on our approach to safety and responsibility, review the model card.
Start using our latest Gemini Audio models:
3.8 Live is rolling out starting today:
- For developers: In the Gemini API and Google AI Studio
- For enterprises: In private preview in Gemini Enterprise and coming soon to Gemini Enterprise for Customer Experience
- For everyone: In Search Live
3.8 Live Extended Thinking is rolling out starting today:
- For developers: In the Gemini API and Google AI Studio
- For enterprises: In private preview in Gemini Enterprise and coming soon to Gemini Enterprise for Customer Experience and Google Workspace business customers
- For everyone: In Gemini Live and for Google AI Pro and Ultra subscribers in Workspace in Docs, and all Google AI subscribers in Gmail and Keep
Get the latest news from Google in your inbox
Sign up for our newsletters with product updates, event information, special offers, and more.
Your information will be used in accordance with Google's privacy policy. You may opt out at any time.
本文内容采集自官方网站,排版和翻译可能与原页面存在差异。
阅读官方全文