2026年9月23日
|
Gemini 3.8 Flash TTS 和 Gemini 3.8 Flash-Lite TTS 是我们迄今为止最具表现力的音频生成模型。在 Google AI Studio、Gemini API、Gemini Enterprise、Gemini Notebook 和 Google Vids 中生成自定义角色语音并指导场景对话。
Leland Rechis
集团产品经理
Alan Cowen
研究科学总监,代表 Gemini 音频团队
今天,我们为 Gemini 家族推出两款新的文本转语音模型,将语音生成从静态预设转变为动态创意工作室。这些模型使创作者、开发者和企业能够创建更丰富、更具表现力的音频体验,同时为 Gemini Notebook 和 Google Vids 等产品带来改进的用户体验。
- Gemini 3.8 Flash TTS: 专为深度创意指导和角色设计而构建。使用自然语言提示从头创建全新语音,为游戏、沉浸式有声书、播客和互动媒体中的角色赋予生命。通过对话术提示、节奏、方言转换和反馈语的精细控制,逐行指导每一句表演。
- Gemini 3.8 Flash-Lite TTS: 专为高容量、高成本效益的规模化而构建。针对大批量配音、音频内容创作和富有表现力的语音代理进行了优化,可对语气、节奏和表现力细微差别进行精细控制。
这些模型补充了我们快速增长的 Gemini 音频家族,此前已推出 3.5 Live Translate、3.5 Transcribe、3.8 Live 和 3.8 Live Extended Thinking。
创建并自定义你自己的语音
从 30 种原创语音扩展到无限语音库。无论你需要完全原创的角色语音还是一致的品牌代言人,我们的 3.8 Flash TTS 模型都能驱动完整的语音工作室。这使你能够为每个时刻创建并使用富有表现力、听起来自然的语音,同时赋能开发者和企业轻松构建自定义音频体验。
生成式语音设计: 借助 Gemini 3.8 Flash TTS,通过自然语言提示在 100 多种语言和方言中自定义角色、口音和语音特征,从头创建定制语音——无论你是在让一只戏剧性的喷火龙栩栩如生,还是在打造一位具有独特地域韵律的魅力旁白。
丰富的语音库: 访问 2,000 多种可直接用于生产的语音,覆盖广泛的语言——包括墨西哥西班牙语、魁北克法语和苏格兰英语等地区变体。
语音复制: 仅需 30 秒的音频样本,即可根据你的声音或你拥有使用权利的声音重建一致的语音特征,并以内置的同意验证、SynthID 水印和 C2PA 凭证为后盾,保护开发者和他们的配音人才。
保存和扩展: 保存并管理你设计的自定义语音,以确保在持续进行的项目中保持一致的表演和最小的漂移。
语音混音: 即将推出,从我们的语音库中选择一个语音,并微调音色、音高、节奏和口音。使用提示来调整特征(例如“添加微妙的美国南方口音”或“让表达更柔和”)。
逐行指导表演
一旦你选定了语音,两款 TTS 模型都能让你精确控制每一行的表达方式。
逐行指导表演: 编写你自己的舞台指示,或让 Gemini 通过自然的脚本提示来引导表达——从冷静的客服代理到低语的悬疑场景。
长格式生成: 在数小时的连续音频中保持高语音质量、自然节奏和角色音色,并将说话人漂移降至最低——非常适合播客和有声书。
原生双说话人场景编排: 从单个脚本无缝指导多轮对话——无论是播客还是戏剧性叙事——同时保持两个语音清晰分离,并具有自然的对话轮替。
脚本化语音爆发和反馈语: 使用非语言提示(如 、、)和积极倾听的插入语(如 |mhm| 或 |yeah|)添加逼真的对话质感,以实现精确的喜剧时机和反应节拍。
获取为全球规模打造的表现力高质量语音生成
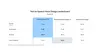
Gemini 3.8 Flash TTS 提供领先的语音自定义能力,在 Hume AI 的语音设计基准测试中夺得总榜第一(71.4),并在口音建模方面领先(60.8)。
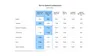
Gemini 3.8 Flash TTS 和 Gemini 3.8 Flash-Lite TTS 在不牺牲可靠性的情况下实现真正富有表现力的表演,还分别在 Hume AI 的整体质量指数中夺得第一和第二名。与 Gemini 3.1 Flash TTS 相比,该模型在长格式内容和双说话人剧本控制等广泛用例上显示出重大改进。
在 Voice Arena 的盲测人类偏好评估中,Gemini 3.8 Flash 和 Flash-Lite TTS 在关键全球语言中跻身竞争对手前列,包括日语、巴西葡萄牙语、越南语、现代标准阿拉伯语(MSA)、墨西哥西班牙语和印地语。凭借对 100 多种语言的支持,这些模型赋能创作者、开发者和企业在全球范围内构建高质量的多语言语音体验。

以信任、同意和透明为基础进行构建
我们构建语音创建和复制能力时采用了严格的保障措施,以帮助保护配音人才、尊重身份并确保内容透明度。对于语音复制,我们的系统利用同意验证:用户必须提供来自语音所有者的口头同意录音,且该录音与参考说话人匹配,然后才能创建语音。
更广泛地说,我们的 Gemini Audio 模型生成的每一段音频片段都通过 SynthID 嵌入了水印。这种不可感知的水印被直接编织进音频输出中,确保 AI 生成的语音仍可被检测,以帮助防止错误信息传播。有关我们安全与责任方法的更多详情,请查阅模型卡。
试用我们全新的 Google AI Studio 音频游乐场
从今天开始,开发者可以在 Google AI Studio 中体验这些全新的语音生成能力。它像一个语音设计工作区一样构建,你可以从零开始提示生成全新的声音身份,或复刻你自己的声音 1,然后将它们直接带入双说话人剧本编辑器,逐行指导语音表达。
在 Google AI Studio 中试用声音复刻。
轻松部署高性能语音界面
通过使用 Gemini API,Agora、LiveKit、Pipecat、Vercel 等开发者平台使开发者能够轻松构建和部署高性能语音生成体验。
我们正在与 Figma、HeyGen、Linguana、Wondercraft、99.co 和 Ollang 等公司合作,他们正在集成我们最新的 TTS 模型,以帮助加速全球配音、以细腻的地区口音本地化媒体,并大规模驱动对话式语音代理。


开始使用我们最新的 Gemini Audio 模型:
Gemini 3.8 Flash TTS 从今天开始推出:
- 面向开发者:在 Gemini API 和 Google AI Studio 中
- 面向企业:即将通过 Gemini Enterprise 中的 API 提供
- 面向所有人:在 Gemini Notebook 中。
Gemini 3.8 Flash-Lite TTS 从今天开始推出:
- 面向开发者:在 Gemini API 和 Google AI Studio 中
- 面向企业:即将通过 Gemini Enterprise 中的 API 提供
- 面向所有人:在 Google Vids 中。
在收件箱中获取 Google 的最新消息
订阅我们的新闻通讯,获取产品更新、活动信息、特别优惠等。
您的信息将根据 Google 隐私政策 使用。您可以随时选择退出。
Sep 23, 2026
|
Gemini 3.8 Flash TTS and Gemini 3.8 Flash-Lite TTS are our most expressive audio generation models yet. Generate custom character voices and direct scene dialogue across Google AI Studio, Gemini API, Gemini Enterprise, Gemini Notebook, and Google Vids.
Leland Rechis
Group Product Manager
Alan Cowen
Director, Research Science, on Behalf of the Gemini Audio Team
Today, we’re introducing two new text-to-speech models to the Gemini family, transforming voice generation from static presets into a dynamic creative studio. These models enable creators, developers, and enterprises to create richer, more expressive audio experiences, while enabling improved user experiences in products like Gemini Notebook andGoogle Vids.
- Gemini 3.8 Flash TTS: Built for deep creative direction and character design. Create entirely new voices from scratch using natural language prompts to bring characters to life across gaming, immersive audiobooks, podcasts, and interactive media. Direct every performance line by line with granular control over acting cues, pacing, dialect shifts, and backchanneling.
- Gemini 3.8 Flash-Lite TTS: Built for high-volume, cost-efficient scale. Optimized for high-volume dubbing, audio content creation, and expressive voice agents with fine-grained control over tone, pacing, and expressive nuance.
These models complement our fast-growing Gemini Audio family, following 3.5 Live Translate, 3.5 Transcribe, 3.8 Live, and 3.8 Live Extended Thinking.
Create and customize your own voices
Scale up from 30 original voices to an infinite library. Whether you need an entirely original character voice or a consistent brand ambassador, our 3.8 Flash TTS model powers a full vocal studio. This enables you to create and use expressive, natural-sounding voices for every moment, while empowering developers and enterprises to easily build custom audio experiences.
Generative voice design: With Gemini 3.8 Flash TTS, create bespoke voices from scratch by customizing role, accent and voice characteristics across more than 100 languages and dialects using natural language prompting — whether you're bringing a dramatic, fire-breathing dragon to life or crafting a charismatic narrator with a distinct regional cadence.
Expansive voice library: Access 2,000+ production-ready voices with broad language coverage — including regional varieties like Mexican Spanish, Quebec French, and Scots English.
Voice replication: Recreate consistent vocal profiles from just a 30-second audio sample of your voice or a voice you have the rights to use, backed by built-in consent verification, SynthID watermarking, and C2PA credentials to protect both developers and their vocal talent.
Save and scale: Save and manage the custom voices you designed to ensure consistent performance and minimal drift across ongoing projects.
Voice remixing: Coming soon, pick a voice from our voice library and fine-tune timbre, pitch, pace, and accent. Use prompts to dial in characteristics (e.g. “add subtle Southern US accent” or “soften the delivery”).
Direct the performance, line by line
Once you've selected your voices, both TTS models give you precise control over how each line is delivered.
Direct performance line by line: Write your own stage directions or let Gemini steer delivery with natural script cues — from a calm customer service agent to a whispered suspense scene.
Long-form generation: Maintain high voice quality, natural pacing, and character timbre across hours of continuous audio with minimal speaker drift — ideal for podcasts and audiobooks.
Native two-speaker scene staging: Direct multi-turn conversations seamlessly from a single script —whether for a podcast or dramatic storytelling—while keeping both voices distinctly separated with natural conversational turn-taking.
Scripted vocal bursts & backchanneling: Add realistic conversational texture using non verbal cues (like , , and active-listening interjections (like |mhm| or|yeah|) for precise comedic timing and reaction beats.
Get expressive high-quality speech generation built for global scale
Gemini 3.8 Flash TTS delivers leading voice customization capabilities, securing the #1 overall spot on Hume AI’s Voice Design Benchmark (71.4) and also leading in accent modeling (60.8).
Gemini 3.8 Flash TTS and Gemini 3.8 Flash-Lite TTS enable truly expressive performances without sacrificing reliability, also securing the #1 and #2 spots respectively on Hume AI’s Overall Quality Index. The model shows major improvements on a wide range of use cases such as long-form content and dual-speaker screenplay control compared to Gemini 3.1 Flash TTS.
In blind human preference evaluations on Voice Arena), Gemini 3.8 Flash and Flash-Lite TTS secure top positions amongst competitors in key global languages, including Japanese, Brazilian Portuguese, Vietnamese, Modern Standard Arabic (MSA), Mexican Spanish and Hindi. With support for over 100 languages, these models empower creators, developers, and enterprises to build high-quality, multilingual voice experiences worldwide.
Build with trust, consent, and transparency
We built our voice creation and replication capabilities with strict safeguards to help protect voice talent, respect identity, and ensure content transparency. For voice replication our system leverages consent verification: users must provide a verbal consent recording from the voice owner that matches the reference speaker before a voice can be created.
More broadly, every audio clip generated by our Gemini Audio models is watermarked withSynthID. This imperceptible watermark is woven directly into the audio output, ensuring AI-generated speech remains detectable to help prevent misinformation. For more details on our approach to safety and responsibility, review the model card.
Try our new Google AI Studio audio playground
Starting today, developers can experience these newspeech generation capabilities inGoogle AI Studio. Built like a voice design workspace, you can prompt entirely new vocal identities from scratch or replicate your own voice 1 , then bring them directly into a dual-speaker screenplay editor to direct line-by-line delivery.
Try voice replication in Google AI Studio.
Deploy high-performance voice interfaces with ease
By using the Gemini API, developer platforms such as Agora, LiveKit, Pipecat, Vercel enable developers to build and deploy high-performance speech generation experiences with ease.
We’re partnering with companies like Figma, HeyGen, Linguana, Wondercraft, 99.co, and Ollang, who are integrating our latest TTS models to help accelerate global dubbing, localize media with nuanced regional accents, and power conversational voice agents at scale.
Start using our latest Gemini Audio models:
Gemini 3.8 Flash TTS is rolling out starting today:
- For developers: In the Gemini API and Google AI Studio
- For enterprises: Coming soon via API in Gemini Enterprise
- For everyone: In Gemini Notebook.
Gemini 3.8 Flash-Lite TTS is rolling out starting today:
- For developers: In the Gemini API and Google AI Studio
- For enterprises: Coming soon via API in Gemini Enterprise
- For everyone: In Google Vids
Get the latest news from Google in your inbox
Sign up for our newsletters with product updates, event information, special offers, and more.
Your information will be used in accordance with Google's privacy policy. You may opt out at any time.
本文内容采集自官方网站,排版和翻译可能与原页面存在差异。
阅读官方全文